PR TIMESでCTOをやっている金子 (@catatsuy) です。
ソースコードの改竄を検知する仕組みを自作してOSSとして公開しました。

PR TIMESでは、レガシーなPHPアプリケーションをEC2で運用しています。セキュリティインシデントに備えて、ソースコードの改竄を検知する仕組みが必要でした。
既存のツールでは我々の要件に合わなかったため、自作することにしました。
今回はその自作した新しいツールの設計思想・開発方針・導入について説明します。
前提
PR TIMESのアプリケーションは以下の環境で動いています。
- AWSのEC2を使って構築されている
- レガシーコードも含まれたPHPのアプリケーション
- デプロイサーバーで必要なライブラリなどをインストールした上で、rsyncでデプロイ
一昔前のPHPアプリケーションならあるあるの構成だと思います。このアプリケーションサーバー向けに、ソースコード改竄検知の仕組みをGoで実装しました。
名前について
ソースコードの改竄からシステムを守る見えざる力を連想して、結界からkekkaiと名付けました。かっこいいので気に入っています。
kekkaiの仕様
まず仕様について考えて、以下の方針で実装することにしました。
- デプロイサーバーでファイルのハッシュ値を計算して、マニフェストファイルを生成する
- マニフェストファイルはファイル保存とS3保存の2つに対応する
- 以下デプロイサーバーが行う処理を生成、アプリケーションサーバーが行う処理を検証と呼称します
- 生成時に除外ルールを設定し、マニフェストファイルに除外ルールを含む
- 検証時は除外ルールに含まれているファイルを検証しないが、検証時に除外ルールを追加することはできない
- シンボリックリンクにも対応する
- シンボリックリンクが随所で利用されているのと、シンボリックリンクを利用して検証を迂回される可能性があるため
- ただしリンクは辿らず、リンク先パス文字列をハッシュして、リンク先の内容変更は検出対象外
- マニフェストファイルにはそれぞれのファイルのパス名・SHA256ハッシュ値・ファイルサイズを含む
細かい仕様について説明していきます。
見るのはファイルの中身のみ
ファイルの中身以外のメタデータ、具体的には各種タイムスタンプなどは見ません。ファイルの中身のハッシュ値から内容が変わっていないかどうかを検証します。
理由としてはファイルのタイムスタンプなどの情報は何らかの作業で変わってしまうことも多いです。そういったことでアラートが鳴ってしまうと、オオカミ少年になってしまいます。本質的に無駄なアラートを鳴らしたくありません。
この問題はtarなどでソースコードを固めてからハッシュ値を取る実装をすると発生します。tarファイルのハッシュ値が違うから攻撃されているかというと、そういうわけではありません。なので個々のファイル内容が変わっていない限りはエラーにしない仕様にしています。
シンボリックリンクの扱い
kekkaiはシンボリックリンクを辿らず、リンクそのものを検証します。os.Lstatでsymlinkかどうかを判定し、os.Readlinkで取得したリンク先文字列にsymlink:というプレフィックスを付けてSHA-256を計算します。通常ファイルは内容をハッシュしますが、シンボリックリンクはこのリンク先文字列のハッシュを保存し、検証時は型(symlinkであること)とリンク先文字列のハッシュの両方が一致することを求めます。これにより、リンク先パスの書き換え、通常ファイルとシンボリックリンクの種別変更、新規追加・削除を検出できます。
また、シンボリックリンクは後述のキャッシュ対象外とし、毎回ハッシュ値を計算します。リンクは短い文字列のハッシュでオーバーヘッドが小さいからです。なお、kekkaiはリンクを辿らないため、リンク先ファイルの内容が変更されても(リンク先パスが同じであれば)検出対象外です。
除外ルールは最初に生成して固定
一番攻撃されやすいのはアプリケーションサーバーなので、アプリケーションサーバーで実行される検証では勝手に無視するファイルを増やせないようにする必要があります。
そこでそもそも検証時は除外ルールを渡せないようにして、マニフェストファイル生成時に全部記述する方針にします。
S3とファイルの両対応
マニフェストファイル自体を改竄される可能性があります。マニフェストファイルをデプロイ前に作成して配布する方法もあると思いますが、その方法だと以下の問題があります。
- 同じディレクトリにマニフェストファイルを混ぜると、マニフェストファイル自体を除外ルールに含めないと、検証時にファイルが追加されたと見なされてしまう
- ソースコードが書き換えられたということはサーバー上の別のファイルも書き換えられる権限を奪取されている可能性が高いので、マニフェストファイル自体も改竄される可能性がある
なのでマニフェストファイルは基本的にS3に配置する想定にしました。S3であればアプリ側のIAMはGetObjectのみ、デプロイ側はPutObjectのみに権限を制御できます。
しかしS3に書き込む機能しかないと、IAMがなければテストもできなくなってしまうので、テスト用にファイルでも出力できるようにしています。
失敗したら非0で終了する
これはCLIツールとして当たり前の仕様です。この仕様により、Mackerelなど、既存の仕組みを使ってアラートなどの設定がやりやすくなります。エラー時は標準エラー出力にエラーになったパスなどが明示されるので、標準エラー出力を通知に含めることで迅速な対応が可能になります。
kekkaiの性質上、デプロイ中に検証をしたりすれば、たまたま失敗する可能性もあります。なので2回連続で失敗したときのみアラートのような設定も監視ツール側の設定で行うことを想定しています。
kekkai側では後述のキャッシュの仕組み以外の状態を持たないようにしているので、kekkai側では制御する機能はありません。
セキュリティ観点の設計
セキュリティ観点で考慮すべき点を紹介します。
満たすべきハッシュ関数の条件
考えられる攻撃手法として、既知のハッシュ値と一致する別の入力値を見つけて、その入力値に置き換えられる可能性があります。なので、それができないハッシュ関数を利用する必要があります。これは第二原像計算困難性と呼ばれています。この第二原像計算困難性を満たすハッシュ関数を利用する必要があるため、高速な安全性の低いハッシュ関数を利用できません。
第二原像計算困難性を満たし、かつ有名で標準で使えるハッシュ関数としてSHA256かSHA512が有名だと思います。SHA512の方が速いという情報も見かけましたが、ソースコードレベルのサイズだと大きな速度差を感じなかったため、もっともメジャーと思われるSHA256を利用することにしました。
マニフェスト保護(S3 / IAM)
マニフェストはS3に保存し、アプリ側はGetObjectのみ、デプロイ側はPutObjectのみのIAMで権限を分離します。必要に応じてVersioningなども併用します。
パフォーマンス制御
kekkaiを作ってみて、ぶち当たった壁が、パフォーマンスでした。ハッシュの計算にはCPUやメモリを利用しますし、計算するファイルの数も多いです。ライブラリのソースコードも含めると、依存しているファイル数は多いです。全ファイルのハッシュ値を求めるのにある程度時間がかかりますし、計算中はCPU・メモリをガッツリ使ってしまいます。
kekkaiの負荷によってサーバーが障害になってしまっては本末転倒です。kekkai側でパフォーマンスを高める仕組みと、ゆっくりやる仕組みの両方が必要になりました。
GOMAXPROCSを使う
Goユーザーならおなじみの仕様です。GOMAXPROCSを1にすれば基本的に1コア以上は使わなくなります。
またkekkaiには—-workersオプションがあり、指定するとハッシュ値計算の同時実行数を制御できるようにしているので、ここに1を指定すれば基本的には1コアしか使わないはずです。デフォルトはGOMAXPROCSと同じ数にしています。
しかしこれだけだと最低でも1コアは利用できるため、大量のファイルを渡すとCPU使用率が100%張り付いてしまう問題がありました。なので次で紹介する方法でrate limitをかけることが重要になります。
golang.org/x/time/rateを使ってゆっくり処理する
今回紹介する方法では一番柔軟に制御することができました。x/time/rateで利用するIOを制限することで、一気に処理をしないようにできます。
golang.org/x/time/rate を利用すれば、以下のようなコードでIOを制限しながら、ゆっくりハッシュ値を求めることができます。
kekkaiでは--rate-limitオプションで速度を調整できるようになっています。当たり前ですが、小さい数値を指定すると、ファイル数が少なくてもかなり時間がかかるようになるので注意してください。
キャッシュを利用する
ローカルにキャッシュファイルを作成して、ファイルのmtime・ctime・ファイルサイズが変わっていなければハッシュ値計算をskipするロジックを入れて、--use-cacheオプションで有効にできるようにしました。
勘違いされることがよくありますが、ctimeはfile change timeで、creation timeではありません。ファイルを変更したら必ず変わる値です。mtimeとファイルサイズは変更しないでファイルを更新する方法はありますが、コストは大きく変わらないので、ついでに確認しています。
キャッシュファイル自体が改竄される可能性が0ではないので、デフォルトでは10%の確率でハッシュ値計算を行っています。毎回全ファイルのハッシュ値計算をすると負荷が高いので、一定数をskipするためにやるという位置づけです。この確率も --verify-probability オプションで変更可能で、0を指定すればキャッシュファイルの内容から変更がなければハッシュ値計算を行わなくなります。
キャッシュファイルの内容と違った場合はファイルのハッシュ値を計算するので、内容が変わってなければアラートにはなりません。
キャッシュファイルはデフォルトではos.TempDir() の中に出力されます。デメリットとしてたまに削除されることがありますが、キャッシュファイルは消えたら再生成されるだけなので、そちらの方がよいと思っています。こちらも--cache-dirオプションで変更することができます。
systemd-runとniceを使う
OS側の機能を使って制限する方法もあります。systemdにはcgroupの機能を使って利用するリソースを制限する機能がありますし、niceを利用すればプロセスの優先度を下げることができます。
CLIで実行する場合はsystemd-runを使えば簡単に指定することができます。例えば以下のような形です。
sudo systemd-run --quiet --wait --pipe --collect \\
  -p Type=oneshot \\
  -p CPUQuota=25% -p CPUWeight=50 \\
  -p PrivateTmp=no -p User=nobody \\
  /bin/bash -lc 'nice -n 10 ionice -c2 -n7 /usr/local/bin/kekkai verify \\
    --s3-bucket kekkai-test \\
    --app-name myapp \\
    --target /srv/app \\
    --use-cache \\
    --verify-probability 0.1'
--quiet --wait --pipe --collectで通常のコマンド実行に近い形で実行することができます。具体的な挙動はsystemd-run自体の出力を抑制 (--quiet) しつつ、実行したコマンドが終わるまで待って、その終了コードを返します (--wait )。そして実行が終わったら一時的に作成されたunitを片付けて (--collect)、デフォルトはjournalに保存される子プロセスの標準出力・標準エラー出力を、呼び出し元であるsystemd-runに返します (--pipe)。
-p CPUQuota=25% -p CPUWeight=50でCPU使用率を25%に制限しつつ、優先度も下げることができます。CPUWeightのデフォルトは100で、同一ホスト上で他のsystemdサービスとCPUを奪い合うときに効く相対的な重み付けです。たとえば他サービスがCPUWeight=100で自分が50なら、自分のCPU割り当ては相手の約半分になります(競合がないときは制限されず、空いている分は使われます)。
今回のkekkaiは強い権限で実行したくないので、-p User=nobodyを指定して、nobodyユーザーで実行されるようにしました。ユーザーにnobodyを指定することで、nobodyユーザーがkekkaiを実行するようになります。kekkaiの実行ユーザーは権限が小さく、かつアプリケーションを実行しているユーザーとは別のユーザーで実行することを推奨します。
さらにこの例ではnice -n 10も併用しています。CPUWeightがcgroup単位でCPU配分を下げるのに対し、niceはプロセス単位でスケジューラに効きます。両方を組み合わせることで、「システム全体でも相対的にCPU割り当てを減らしつつ、その枠の中でも順番を後回し」にできます。
ちなみにIOReadBandwidthMax など、IOの帯域幅も変更できるオプションがあります。今回は利用しませんでしたが、cgroup経由でリソースを絞っても良さそうです。
気をつけてほしいのはPrivateTmp=noの設定で、こちらを設定しないと/tmpがプロセス毎に違うディレクトリになります。前述のキャッシュを利用する場合はキャッシュファイルを読み込めなくなります。キャッシュを利用する場合は指定してください。
またGo 1.25未満ではcgroupを使っていても、GOMAXPROCSが親マシンのCPU数になる問題がありました。Go 1.25からcgroupも考慮されるように変更されたので、kekkaiではGo 1.25以上のみを対象にしています。
Go Tips
利用したGoのTipsを紹介します。
hash.Hashはresetして使い回す
大量のファイルをハッシュするときは、hash.Hashを毎回New()で作り直さず、極力Reset()して使い回しましょう。sha256.New()は1つ1つはそこまで重くないですが、ゼロコストではなく、ファイル数×並行数だけオブジェクトと内部バッファが積み上がると、GCコストとキャッシュミスが無視できなくなります。
一方、Reset()は内部状態だけを初期化するので、同じハッシュ関数・同じゴルーチン内での再利用なら安全かつ効率的です。あわせてio.CopyBufferのバッファもワーカー単位で使い回せば、追加の割り当てをほぼ抑えられます。ファイル毎にこれらを作成すると遅くなります。
kekkaiの導入・運用
実際にPR TIMESへ導入したので、そのときの導入・運用について説明します。
デプロイサーバー
PR TIMESのデプロイはシェルスクリプトで実装されており、デプロイサーバー上でライブラリのダウンロードなど必要な処理を行った後に、rsyncを行っています。

なのでデプロイスクリプトの最後にkekkai generateをして、マニフェストファイルを作成します。ログファイルやNFSのマウントポイントなど、無視する必要があるディレクトリはこの時点ですべて列挙しておくことがポイントです。例えば以下のようなコマンドを実行したとします。
kekkai generate --target /var/www/app \\
 --s3-bucket 'kekkai-test' \\
 --base-path production \\
 --app-name kekkai \\
 --exclude ".git/**"
そうすると指定したS3バケットに production/kekkai/manifest.json というファイル名でマニフェストファイルが保存されます。もちろんEC2にIAM経由で書き込み権限を渡す必要があります。今回利用するS3バケットのs3:PutObjectの権限をIAM経由でEC2に付与すれば利用できます。
オプション次第でローカルのファイルとして出力することも可能ですが、そのファイルを同じディレクトリ内でデプロイしてしまうと、そのファイルのせいでkekkai verifyが通らなくなってしまうので注意してください。
指定したbase-path(デフォルト:development)とapp-nameがそれぞれディレクトリ名になるので、同じS3で複数の設定を配置することも可能になっています。誤って本番を上書きしないために、本番環境ではbase-pathを固定の値にし、運用で明示的に管理することをおすすめします。
前述の通り、excludeしているディレクトリの情報もマニフェストファイルに保存されるので、この時点で漏れがないようにする必要があります。なおkekkai generateの時点ではディレクトリやファイルの存在チェックはしていないので、デプロイサーバーに存在していなくても問題ありません。
アプリケーションサーバー
アプリケーションサーバー上で最低限必要なkekkaiのコマンドは以下です。
kekkai verify --target /var/www/app \\
 --s3-bucket 'kekkai-test' \\
 --base-path production \\
 --app-name kekkai
この状態でエラー時はステータスコードが非0で、標準エラー出力にエラー内容を出力して終了します。
実運用を考えると、以下のことを考える必要があります。
- アプリケーションサーバーからS3に書き込みができると改竄が可能なので、読み込み権限のみが必要
- 失敗時にアラートをしたいので、Mackerel経由で実行する
- 普通に実行するとEC2上のリソースをかなり使ってしまうので、
--rate-limitオプションで速度を抑える - 完了時間を短くするためにキャッシュを有効にする
IAMはデプロイサーバーとは異なり、s3:GetObjectのみを渡します。
EC2上のIAM
EC2のIAMは例えばterraformだとアプリケーションサーバーの設定は以下のようになります(完全な設定ではありません)。
data "aws_iam_policy_document" "main_ec2" {
  statement {
    sid    = "AllowEC2ToGetS3ObjectKekkaiManifest"
    effect = "Allow"
    actions = [
      "s3:GetObject"
    ]
    resources = [
      "arn:aws:s3:::kekkai-test/*"
    ]
  }
}
Mackerelの設定
失敗時にアラートをしたいですが、1回失敗したときにアラートをしてしまうと、デプロイ中にアラートが鳴る可能性があります。誤検知が多いとオオカミ少年になってしまうので、2回以上連続で失敗したらアラートする設定にするためにmax_check_attemptsを利用します。
またMackerelのチェック監視はデフォルト30秒でタイムアウトしてしまうので、timeout_secondsを伸ばす必要があります。
例えば1時間に1回チェックして、2回連続で失敗したらアラートをする設定は以下のようになります。
[plugin.checks.check_kekkai_verify]
command = [
    "systemd-run", "--quiet", "--wait", "--pipe", "--collect",
    "-p", "Type=oneshot",
    "-p", "CPUQuota=25%", "-p", "CPUWeight=50",
    "-p", "PrivateTmp=no", "-p", "User=nobody",
    "/bin/bash",
    "-lc", "nice -n 10 ionice -c2 -n7 /usr/local/bin/kekkai verify --s3-bucket kekkai-test --app-name app --base-path production --target /var/www/app --use-cache --rate-limit 10485760 2>&1",
]
check_interval = 60 # 1 hour
timeout_seconds = 1200
max_check_attempts = 2
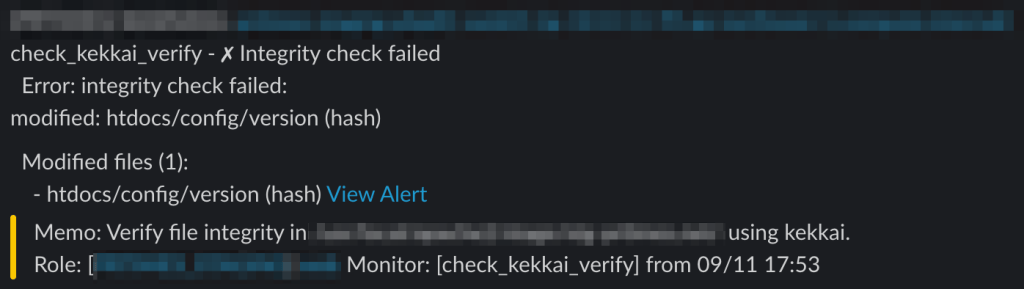
エラー時は標準エラー出力にエラー内容が出ます。Mackerelは標準出力の内容を通知してくれます。kekkaiは標準エラー出力にエラーを出力するので、リダイレクトをすることで具体的にどのファイルが改竄されたのかをSlackなどに通知することができるようになります。以下のように実際に差分があるファイルを通知させることができます。
なおMackerelはrootユーザーで実行されているので、systemd-runコマンドも実行可能です。
キャッシュファイルを有効にする
キャッシュファイルを有効にすることで2回目以降の実行が早くなります。
キャッシュファイル自体のハッシュもキャッシュファイルに含めているので、改竄を検知したらキャッシュを無効にしてくれます。攻撃者がハッシュも含めて整合性を保ったまま改竄する可能性もありますが、その場合でもデフォルト10%の確率でハッシュ値を再計算します。また/tmp上のファイルは定期的に削除されるため、削除されたタイミングでキャッシュが再生成されて正常な状態に復旧します。
実際のパフォーマンス
PR TIMESの環境(約17,000ファイル)での実測値を参考として共有します。
- マニフェスト生成(generate): 約数秒
- デプロイサーバーで実行、速度制限なし
- 検証(verify): 約4-5分
--rate-limit 10485760(10MB/s)で速度制限--use-cache有効、キャッシュヒット時は約25秒程度に短縮- アプリケーションサーバーで1時間ごとに実行
この差は意図的なもので、generateはCDの一部として高速に終わらせたい一方、verifyは本番サーバーへの影響を最小限にするため、あえてゆっくり実行しています。5分程度かかっても1時間ごとの実行なら十分間に合いますし、サーバーへの負荷も許容範囲内です。
Claude Codeを使って
ここまで色々書いてきましたが、kekkaiを実装したのはClaude Codeで、私が実装した箇所はほとんどありません。Claude Codeを使ってみた感想を書いておきます。
スタイル合わせ
当たり前ですが、Claude Codeに一からコードを書かせると自分のスタイルと全く違うコードが出てきます。そこで、自分が以前書いたコードを参考にするように指示したところ、かなり近いスタイルになりました。何を参考にしてほしいかを明示することが重要だと感じています。
手で直した点
今回、手で直したのは主に2つです。
- 新しいGoの機能をなかなか使ってくれなかったので、その部分だけ書き換えた。
- ドキュメントに変なスペースが入っていたので整えた。
新しいGoの機能については折角手で書き換えたものに対して「そんな機能はない」と言われて勝手に書き換えられてしまいました。書き換えないように厳命をしたところ、後でそのことがCLAUDE.mdにその旨が追記されたので、そういう風に動くのかと感心しました。
この辺りは、MCP経由でコンテキストを渡したり、hooksで設定をうまく入れられれば回避できる気がしています。
進め方
Claude Codeが変な実装をし始めることはあります。そういうときは一気に実装させず、都度問題点を指摘しながら少しずつ進めると、概ね問題ないコードになりました。
ザックリした指示だとAIは自分に都合の良い解釈をしてサボり始めます。AIが手抜きをし始めたら、手抜きができないように明確で迷わないような指示を出すことを心がけました。
品質と割り切り
出力されるコードの品質は、自分が1から書くものより低いと感じることはあります。ただ、完全に自分が書きたいコードをAIに書かせるという発想自体がAI時代では違うのかもしれない、と考えています。細かい部分は好みの問題として割り切り、あまり気にしないようにしました。これは、他人のコードレビューで自分の好みを押しつけない感覚に近いです。
100点を1つ出すのではなく、80点をたくさん出すことを意識して進めてみました。
勝手に実装された機能の例
気を利かせて無駄な機能を勝手に実装していたこともありました。例えば、全ファイルのハッシュを結合して1つのハッシュを作り、それを比較して個別検証をskipできるようにする、というものです。パフォーマンス向上のつもりで入っていましたが、私の指示で実装した機能ではありません。実際実装されていることに気づくのも遅れました。
この実装についてClaudeにもChatGPTにも「パフォーマンス上意味がある」と言われましたが、違和感があったので試しに削除してみたところ、パフォーマンスはほとんど変わりませんでした。効果が分からない機能で実装を複雑にする必要はないので、最終的に削除しています。
こういう一見それっぽい機能が紛れ込む可能性はあるので、注意してレビューする必要があります。この件は、自分自身も当初は「意味があるのか、あるとしてどの程度か」が分かりませんでした。ただ、こういった判断の難しさは人間でもよくあることで、AIだけの問題ではないとも感じています。
READMEの出力
READMEを書かせるのは本当に便利でした。コードを調査しつつ仕様を確認して、英語でREADMEを書き上げてくれるのは助かります。私は英語が得意ではないので、ここは圧倒的にAIの方が強いと感じました。
まとめ
総じて、気をつけることは人間に仕事を依頼するときと変わらないと思っています。ザックリした指示だと迷走しますし、意図と違うことをやることもあります。ある程度タスク量を調整し、どこまでやってほしいかを明確にして、指示したタスクが完了したら、後続のタスクをまた指示する、というように指示を具体化するマネジメントが必要です。違いは「相手が人間かAIか」くらいで、やること自体は同じ、という感覚です。
最後に
最初、Claude CodeでVibe Codingを軽く試したところ、ひとまず動くものができて喜んでいました。しかし実際にソースコードを読み込むと様々な穴が見つかり、結局は色々と手を入れることになりました。
とはいえ、AIがなければこのレベルの実装を短期間に、しかも他の仕事と並行して進めるのは間違いなく無理でした。頭の中で想像したソフトウェアが目の前で実際に動く形になるのは本当に楽しく、こんな時代に生まれてよかったと本気で思います。
だからこそ、可能性の大きいAIとどううまく付き合うか、今後も模索していきたいと思います。