こんにちは。開発本部で主にバックエンドの開発をしている ueeda です。
PR TIMES Webクリッピングというサービスで使用していた MongoDB を AWS のマネージドサービスである Amazon DocumentDB(以降 DocumentDB) に移行させるプロジェクトを進めていたのですが、先日移行が終了したので、紹介したいと思います。
PR TIMES Webクリッピング(以降クリッピング)とは様々なサイトから記事をクロールし、その記事にユーザーが設定したキーワードが含まれていればクリップしたりなど、メディア露出の調査・分析などが可能なWebアプリケーションです。
MongoDB の構成やその用途
移行の話をする前にどのような構成でどのようなデータの保持に MongoDB を用いていたのか紹介します。
構成と各サーバーの役割
- mongos
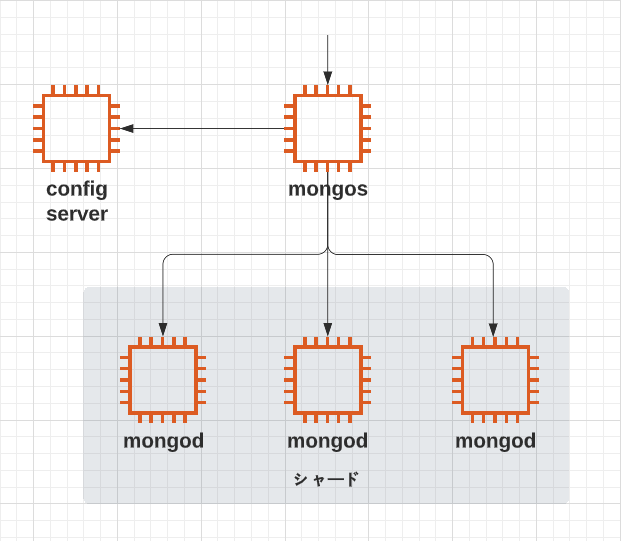
- クエリのルーティングを行います。アプリケーションから MongoDB へリクエストした場合、そのサーバー内に立ち上がっている mongos へまずリクエストします。そして config server にリクエストを行い後述するデータを取得しそれに応じて mongod へクエリを転送します。
- config server
- 設定サーバーです。ここにはシャーディングのメタデータが格納されており、どのサーバーがどのデータを持っているかを保持します。
- mongod
- config server からのデータを得た mongos がクエリを転送し実際にクエリを実行して mongos に返します。 クリッピングでは Primary 1台、Secondary 2台を1シャードとし、それが3シャードの合計9つの mongod の構成となっており、それらは9台の Amazon EC2 インスタンスで構築されています。
mongos についてはこちら
使用用途
その MongoDB をどこに使っていたかですが、先述したクリッピングで使用していました。
クリッピングでは様々なサイトから記事を収集するためのクローラーが動作しています。そのクローラーが記事のデータを保存する目的で MongoDB を使用していました。
クロールする記事数は1日に約10万~15万件で、移行を開始した当初は1.6億件ほどのデータがありデータ量としては約1TBほどのデータを MongoDB が保有していました。
保存しているだけではなく、アプリケーションで記事のタイトルとその URL を提供しているため MongoDB から取得して表示しています。
また、PR TIMES Webクリッピングには過去記事検索という機能があります。これは過去1年間に遡り任意のキーワードを含む記事のタイトルとリンクを提供するものです。検索は OpenSearch へ行うのですが、OpenSearch のデータは MongoDB からデータをインサートしています。
総じてクローラーが取得した記事データを保存し、必要な箇所へ記事データを渡す役割を持ちます。
なぜ移行する必要があったのか?
今まで運用していた MongoDB はメンテナンスされておらず、バージョンも塩漬け状態でした。さらに、MongoDBに関する問題が起きた際、私たちには運用知識が不足していることが明らかになりました。このため、高い運用コストと人的リソースの制約を解消する目的で、DocumentDB への移行を考えました。
それに合わせてシャーディング構成というのもボトルネックになっていると感じていました。MongoDB のサーバーは全部で9台あり、さらに mongos、config server が各バッチサーバーやアプリケーションサーバーに存在している状況で管理が必要な箇所が多岐に渡り複雑です。
AWS マネージドサービスの DocumentDB にすればインフラ管理面で運営上の負担が大幅に減少します。例えば、DocumentDB はディスク容量が逼迫すると自動で容量を拡張しスケールします。EC2 上で運用している場合 EBS の拡張は都度実施しなければなりません。
また、EC2 上で運用している MongoDB の場合障害が起きた際も全て自分達で調査が必要ですが、DocumentDB 側で問題が起きた場合 AWS のサポートが受けることができ、迅速に復旧することができます。
これらからシステムの可用性が向上し、最終的には顧客体験の改善に繋がると考え移行しました。
DocumentDBの構成
DocumentDB の構成を決定します。選択できるのは2種類でシャーディング構成かレプリカ構成です。MongoDB の構成がシャーディング構成で運営上厳しい現実を体感していたのと、アプリケーションの負荷的にシャーディングである必要はないと判断したためレプリカ構成にしました。
インスタンス構成ですが、DocumentDB は最低リーダーとフォロワー1台ずつの2台構成で稼働するようです。しかし、ベストプラクティスとしては3台(フォロワー2台)構成にするのが良いとされているようなので、そちらに則る形で今回は3台構成としました。
MongoDB でシャーディング構成にする際の注意点
私たちが運営していた MongoDB のシャーディング構成でアンチパターンに遭遇したので、ついでに紹介したいと思います。MongoDB には「ハッシュ」と「レンジ」2種類のシャーディング方法があります。
簡単にまとめると以下のような場合にそれぞれハッシュかレンジを選定します。
- ハッシュ
- データの均等な分散が重要な場合等
- レンジ
- データの順序が重要な場合や、クエリが特定の範囲に集中する場合
クリッピングで最適なのはレンジだと考えます。記事のタイトルと URL をアプリケーションで使用しているのですが、大体「x月x日 〜 x月x日の記事を表示」という具合に時刻で sort した結果を表示するためです。
実際の設定を見てみます。(以降コマンドの実行結果を書いていますが、一部ぼかしています)以下はシャーディングに関する情報を出力してくれる sh.status() を実行した結果の一部です。
.
.
.
databases:
        {  "_id" : "sample",  "primary" : "shard0000",  "partitioned" : true }
                my_db.my_collection
                        shard key: { "_id" : 1 }
                        unique: true
                        balancing: true
.
.
.
通常、_id は ObjectID がデフォルト値だと思いますが、クリッピングでは _id をドキュメントごとに1ずつインクリメントして使用していました。
上記 status で今回注目したいのは databases の shard key の箇所です。ここを見ればハッシュ、レンジどちらが使われているか、またどのカラムが shard key として使用されているのかがわかります。今回クリッピングで使われていたのはレンジで、 key は _id が指定されていました。(ハッシュを使用していれば shard key: { "_id" : hashed } のような表記になるはずです。)
レンジが使われていたことは想定していた通りの理由で問題ないかと思いますが、 _id が指定されていることで結果としてシャーディング構成の意味がなくなっていました。シャーディング構成をとる上で shared key にどれを指定するかは重要です。
主に以下のようなものが挙げられています。
- 高頻度でクエリに使用される
- タイムスタンプや連続する id ではない
単調に増減する key を shared key として選定してしまうと単一のシャードにインサートが偏ってしまうことが公式ドキュメントにも書かれています。
ここまでの情報を合わせて実際に各シャードのデータ量を確認してみました。(単位は byte です)
- シャード1
shard01:SECONDARY> db.runCommand({dbstats: 1})
{
        "db" : "my-db",
	"collections" : 3,
	"objects" : 112183213,
	"avgObjSize" : 3522.205047630433,
	"dataSize" : 395132279088,
	"storageSize" : 231030939648,
	...
}- シャード2
shard02:SECONDARY> db.runCommand({dbstats: 1})
{
	"db" : "my-db",
	"collections" : 2,
	"objects" : 25163805,
	"avgObjSize" : 3556.9854448085257,
	"dataSize" : 89507288121,
	"storageSize" : 115276460032,
	...
}- シャード3
shard03:SECONDARY> db.runCommand({dbstats: 1})
{
	"db" : "my-db",
	"collections" : 2,
	"objects" : 25141095,
	"avgObjSize" : 3562.1421398312204,
	"dataSize" : 89556153941,
	"storageSize" : 115918303232,
	...
}
ここで注目したいのは、objects です。これはドキュメントの数、つまりデータ数なのですが、シャード1は約1億1千万件入っているのに対して、シャード2、3は約2千万件ほどしか入っていません。
シャーディングのタイプがレンジの場合に単調増減する key を shared key に指定することでインサート時のルーティングが狂いシャード1に大部分のデータが集まってしまっています。
これはうまくシャーディングができていない例で、シャーディングの強みであるデータを複数のサーバーに分散し1台あたりの負荷を減らすという恩恵があまりありません。
このようにシャーディング構成ではシャードキーをきちんと選定しないといけないということがわかるかと思います。
以上が遭遇したアンチパターンでした。
データ移行の準備
話を戻して、データ移行について触れていきます。DocumentDB は MongoDB の互換性があるデータベースですが、互換性があるというだけで全てが同じわけではありません。
例えば DocumentDB のストレージエンジンは独自のものが使用されていますが、MongoDB はデフォルトで WiredTiger というものが採用されています。その他サポートされていない機能や演算子があります。
演算子の互換性チェック
そのためまずはアプリケーションで使用されている演算子が DocumentDB でも使用可能かをチェックします。ありがたいことにクエリ演算子の互換性をチェックするための CLI ツールが、AWS 公式から提供されているため、これを使用しました。

ツールの詳しい使い方は README 等を読んでいただければ良いかと思うので、ここでは手順を紹介します。
- アプリケーションで使われている全てのクエリを洗い出す。
- 1でまとめたクエリを実行する。
- MongoDB のログを確認して以下のようなクエリの実行ログを一つのログファイルに集める。
2024-01-01T07:28:51.071+0000 I COMMAND [conn61] command my-db.my_collection command: find { find: "my_collection", filter: { _id: { $in: [ 1, 2 ] } } } planSummary: IXSCAN { _id: 1 } keysExamined:3 docsExamined:2 cursorExhausted:1 keyUpdates:0 writeConflicts:0 numYields:0 nreturned:2 reslen:6539 locks:{ Global: { acquireCount: { r: 2 } }, Database: { acquireCount: { r: 1 } }, Collection: { acquireCount: { r: 1 } } } protocol:op_query 0ms - compat tool を使用して互換性があるかをチェックする。
今回の実行結果は以下のようになり、互換性があることが確認できました。
processing file clipping_query.log

Processed 1 files, skipped 0 files

No unsupported operators found.

The following 8 supported operators were found:
  - $in | found 20 time(s)
  - $set | found 13 time(s)
  - $gte | found 6 time(s)
  - $lte | found 4 time(s)
  - $gt | found 2 time(s)
  - $eq | found 1 time(s)
  - $lt | found 1 time(s)
  - $or | found 1 time(s)
ここでサポート外の演算子があった場合、そのクエリの改修作業も発生したと思われますが、今回は行わなくても問題ありませんでした。
データ移行の実施
いよいよ、データを移行していきます。この時 MongoDB には1.6億件ほどのデータがありデータ量としては約1TBほどのデータを MongoDB が保有していました。
クリッピングでは OpenSearch も使用しており、OpenSearch には MongoDB からデータをインポートしています。OpenSearch には過去1年間の記事データを保管する仕様になっており、また DocumentDB のパフォーマンス・メンテナンス性を考えてデータ量を減らしておきたかったため、移行先のDocumentDB にも OpenSearch に必要な1年間のデータを保持することにしました。
よって、最終的に移行するデータは約8000万件で、データ量としては約500GBとなりました。
選択できた移行方法は以下の3つがありました。
- AWS DMS
- AWS が提供しているデータベースのマイグレーションサービスです。DocumentDB にも対応
- mongorestore
- mongorestore でデータ DocumentDB にデータを入れていく方法
- CSV ファイルを使用して DocumentDB に入れていく
- MongoDB のデータを CSV ファイルにしてそれを使用して mongoimport にて DocumentDB に入れていく方法
これらの選択肢を検討する際、以下の点に注意しました。
- MongoDB に入っているデータの約半分の移行で事足りる
- アプリケーションが正常稼働するのかテストする
- アプリケーションを書き換えて MongoDB と DocumentDB の両方に書き込みできること
- DocumentDB に入れもれたデータがないか
- DocumentDB に入れたデータが MongoDB のデータと比較して壊れていないか
- DocumentDB に切り替えた後に問題が発生した場合 MongoDB に切り戻しができること
等です。
まず方法1の AWS DMS ですが、DocumentDB に DMS を使用してデータを移行した場合、全てのデータの移行が終わった後にアプリケーションからのリクエストを送ることになり、問題が発生した場合の切り戻しも困難になります。
AWS DMS を使用した DocumentDB へのデータ移行等について
方法2で mongorestore を実行する際は、データの整合性や MongoDB のパフォーマンス等の観点から MongoDB が完全停止していることがほぼ前提となりメンテナンス必須なためダウンタイムが発生します。
また、一度 MongoDB の EC2 を停止させて再起動した際に mongod プロセスがちゃんと立ち上がるか、それぞれがシャードとして認識されるのかが定かではなく、予期しないダウンタイムが発生する可能性もあったため採用しませんでした。
方法3を選んだのは、CSV ファイルを使用して mongoimport を使用するだけで済むため、MongoDB のダウンタイムも発生しません。
さらに DocumentDB に切り替えた後に何かあった場合でも MongoDB からデータを読むように切り戻しを行えば迅速に復旧可能であるためです。
また、記事データを社内の誰でも見れるように MongoDB から BigQuery に転送したいという要望もありました。BigQuery は CSV ファイルを使用してデータを簡単にインポートすることが可能なため CSV を作成する仕組みをこのタイミングで構築すればそれも可能になります。
これらの理由から最終的に方法3を選択しました。
データ不整合がないかアプリケーションをテストする
データをDocumentDBに移行した後、MongoDBのデータとの齟齬がないか確認します。DocumentDB と MongoDB からデータを読み出し、DocumentDB から得られたデータを比較のみに用い、アプリケーションでは MongoDB のデータを使用します。
これにより、本番環境でもデータの比較を行うことができるだけでなく、この時点でDocumentDB の負荷がどの程度になるかを把握できます。データは配列なので、PHP の組み込み関数である array_diff() を比較に使用していました。array_diff() は第一引数と第二引数に渡されたデータの差分を出力してくれる関数です。
ソースコードは以下のような感じになります。
<?php
.
.
.
$documentDbData = getDocumentDB();
$mongoDbData = getMongoDB();
if ($documentDbData['_id'] === $mongoDbData['_id']) {
    $diff = array_diff($documentDbData, $mongoDbData);
    $this->log->warn('array diff: ', $diff);
}
return $mongoDbData;
.
.
.
ここで差分が出たデータに関しては MongoDB から入れ直しを行い、差分が出てこなくなることを確認ということを繰り返します。先述した通りこの段階では DocumentDB へデータの読み取りは行なっていますが、実際に使用しているデータは MongoDB のデータなため、例えば「壊れてデータが画面に出てしまう」等の不具合は起きません。
このような過程を得てデータの読み込み先を DocumentDB だけに切り替えることで、アプリケーション側の切り替えは完了です。この時点では何かあった時に切り戻しができるように MongoDB への書き込みは続けている状態です。
データ移行後に発見したデータの不整合
- データの型違い
前提として、MongoDB のデータは BigQuery に転送していました。MongoDB のスキーマには del_flag が boolean 型で入っていましたが、BigQuery 側のスキーマが int になっており CSV ファイルにする際に0にしていました。
DocumentDB にデータを入れる際にもその CSV を使用していたので、DocumentDB には del_flag が int の0(or 1)で入ってしまっていました。
これは array_diff() で行なった配列の差分出力に問題があり、array_diff() の挙動を勘違いしたため発生してしまいました。
https://www.php.net/manual/ja/function.array-diff.php
(string) $elem1 === (string) $elem2の場合のみ、 つまり、文字列表現 が同等な場合のみ、 2つの要素は等しいとみなされます。
ドキュメントの上記文言を読んで「型まで比較してくれるんだな」と誤解してしまい、array_diff() の型の挙動まではチェックしなかったことが原因です。
実際の array_diff() の挙動は「比較前に string にキャストして比較」しているので、例えば以下のような配列の比較だと差分は出てくれません。
php > $array = ['key' => 'value', 'key' => true];
php > $array2 = ['key' => 'value', 'key' => (bool)1];
php > var_dump(array_diff($array, $array2));
array(0) {
}
これを型違いの差分を出すために以下のように改修しました。
<?php
.
.
.
$documentDbData = getDocumentDB();
$mongoDbData = getMongoDB();
if ($documentDbData['_id'] === $mongoDbData['_id']) {
    $arrDiff = [];
    foreach (array_keys($mongoDbData) as $key) {
        if ($documentDbData[$key] === $mongoDbData[$key]) {
            $arrDiff[] = "{$key}. DoccumentDB: {$documentDbData[$key]}, MongoDB: {$mongoDbData[$key]}";
        }
    }
}
return $mongoDbData;
.
.
.
MongoDB データの全てのキー分ループして === で比較するようにしました。これによりお互いを厳格に比較するようにしたので、型が違う場合も差分として出力されます。ちなみに DocumentDB の del_flag は PHP でスクリプトを書いて1万件ずつアップデートして対応しました。
- インポート漏れのデータ
今回インポートしたデータは過去1年間に保存されたものでしたが、それだけでは不十分であることがわかりました。
クリッピングのクローラーは、重複する記事を保存しないように、URLを取得するたびに MongoDB へリクエストを行い重複チェックを行っています。
しかし、データの読み込み先を DocumentDB に切り替えたところ、DocumentDB には過去1年間のデータしか存在していませんでした。その結果、2018年から2022年11月頃までに公開された古い記事が大量に再度クロールされてしまいました。
また、データの不整合をアプリケーションでテストしたということを先述しましたが、一部でそのチェックも漏れてしまったことで事前にインポート漏れのデータがあることに気づけませんでした。この問題を解決するために DocumentDB に記事データを再度入れ直すのは DocumentDB のパフォーマンスやメンテナンス性を考慮して悪手だと判断し、別の解決策を模索しました。
DocumentDB ではパフォーマンス・メンテナンス性を考えて間近のデータだけを保持するようにしたいです。そこで、クロール済みの URL を保存するテーブルを MySQL に新規作成し、そのテーブルに URL が存在する場合は、 DocumentDB に保存しない処理を実装することで問題に対応しました。
事後対応
アプリケーションの対応が終了して正常に稼働していることを確認した後は MongoDB の EC2 インスタンスを終了させて移行作業は終了となります。終了時には念の為そのインスタンスにアタッチされている EBS をデタッチして終了させました。
インスタンスを終了させる際にボリュームも削除されるようになっているため、ボリュームの削除をしたくない場合は事前にデタッチしてから終了させます。
最後に
PR TIMES では AWS エンタープライズサポートを契約しています。また、今回移行するにあたり DocumentDB に精通している方を AWS 社内から呼んでくださり、移行のアドバイス等もしていただき、非常に助かりました。
私自身、このようなデータベースの移行作業は初めて行なったためデータ移行時の注意点はじめ学ぶことがたくさんあり、大変でしたがやり切れてよかったです。
この記事が DocumentDB 採用等の役に立てたら幸いです。